Webseite bei Bing anmelden
Bing beliefert Copilot, ChatGPT, DuckDuckGo und Ecosia. So trägst du deine Seite in zehn Minuten in die Bing Webmaster Tools ein, bestätigst sie und hältst sie mit IndexNow aktuell.
PDF-Dateien und Bilder tauchen in der Suche auf, obwohl sie dort nichts verloren haben. So schließt du sie zuverlässig aus.
Normalerweise nimmt Google alles in den Index, was der Crawler auf einer Website findet. Meistens ist das gewollt. Manchmal ist es das aber nicht, und gelegentlich ist es sogar schädlich: wenn plötzlich einzelne Bilder, PDF-Dateien, die Sitemap oder eine vergessene Textdatei als eigenes Suchergebnis auftauchen.
Bei Bildern hat das einen sehr praktischen Grund. Über die Rückwärtssuche lassen sich Kopien binnen Sekunden aufspüren, und genau das nutzen Bildagenturen und darauf spezialisierte Kanzleien, um Abmahnungen zu verschicken.
Wer fremde Bilder einsetzt, sollte nicht auf noindex hoffen, sondern die Lizenz klären. Das hier ist Aufräumen, keine Tarnkappe.
Daniel Weihmann
Der verbreitetste Irrtum bei diesem Thema: Man könne Dateien über die robots.txt aus dem Index halten. Das funktioniert nicht.
Die robots.txt steuert das Crawling, nicht die Indexierung. Diesen Unterschied nicht zu kennen, kostet Leute regelmäßig genau die Seite im Index, die sie loswerden wollten.
Daniel Weihmann
Eine Sperre dort sagt nur: Ruf diese Datei nicht ab. Kennt Google die Adresse trotzdem, etwa über einen Link, kann sie weiterhin im Index landen, dann eben ohne Inhalt. Für Dateien brauchst du deshalb einen anderen Weg.
Bei einer HTML-Seite schreibst du noindex einfach in den Quelltext. Bei einem Bild oder einer PDF-Datei geht das nicht, dort gibt es keinen Kopfbereich, in den man etwas schreiben könnte. Also legt man die Anweisung eine Ebene tiefer, in die Antwort des Servers.
Fast jeder Hoster stellt dafür das Apache-Modul mod_headers bereit. Damit lässt sich jeder Antwort ein zusätzliches Feld mitgeben, und eines davon ist X-Robots-Tag. Für die Suchmaschine wirkt es genauso wie ein noindex im Quelltext, nur sieht es kein Mensch.
Um alle JPG-Dateien auszuschließen, deren Name mit „bild-“ beginnt, kommt dieser Block in die .htaccess:
<IfModule mod_headers.c>
  <FilesMatch "bild-.*\.jpg">
    Header set X-Robots-Tag "noindex"
  </FilesMatch>
</IfModule>
Alle anderen Bilder bleiben unberührt. Wer mehrere Dateitypen auf einmal erwischen will, erweitert das Muster:
<IfModule mod_headers.c>
  <FilesMatch "robots\.txt|sitemap\.xml|readme\.txt|image-.*\.(jpg|png)">
    Header set X-Robots-Tag "noindex"
  </FilesMatch>
</IfModule>
Gelesen wird das so: Treffe auf robots.txt oder sitemap.xml oder readme.txt oder auf JPG- und PNG-Dateien, deren Name mit „image-“ beginnt. Passt eines davon, setze im Header noindex.
Tauchen Dateien in Google auf, die dort nichts zu suchen haben?
Schick mir ein Beispiel aus der Suche. Ich finde heraus, warum die Datei im Index ist, und sorge dafür, dass sie verschwindet und nicht wiederkommt.
Prüfen lässt sich das an der Serverantwort. Am schnellsten geht es auf der Kommandozeile:
curl -I https://deinedomain.de/bilder/bild-beispiel.jpgIn der Ausgabe muss die Zeile x-robots-tag: noindex stehen. Wer lieber im Browser arbeitet, findet dieselbe Information in den Entwicklerwerkzeugen unter Netzwerk, wenn man die Datei anklickt und sich die Antwort-Header ansieht.
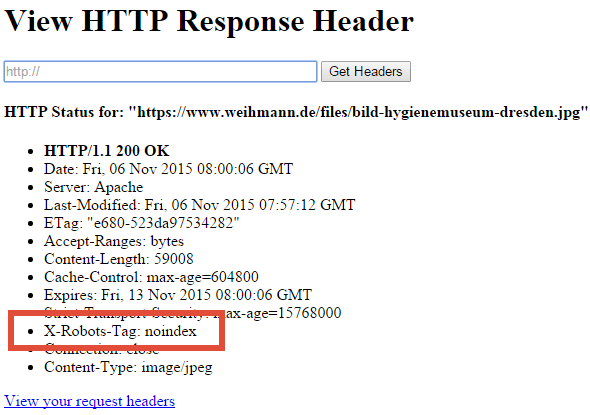
Sind die Dateien bereits im Index, dauert es eine Weile, bis sie verschwinden. Beschleunigen lässt sich das über die Search Console, indem du die betroffenen Adressen dort noch einmal prüfen und neu abrufen lässt.
Bei manchen Redaktionssystemen lässt sich für einzelne Unterseiten kein noindex setzen, und weil die Seite physisch nicht existiert, greifen die Regeln von oben auch nicht. Für diesen Fall gibt es einen Umweg über eine Umgebungsvariable.
Ich brauchte das zuletzt bei einer Pagekit-Installation für die Adressen /impressum und /datenschutz, für die das System selbst keine Möglichkeit vorsah:
SetEnvIf REQUEST_URI "^/(impressum|datenschutz)" NOINDEX
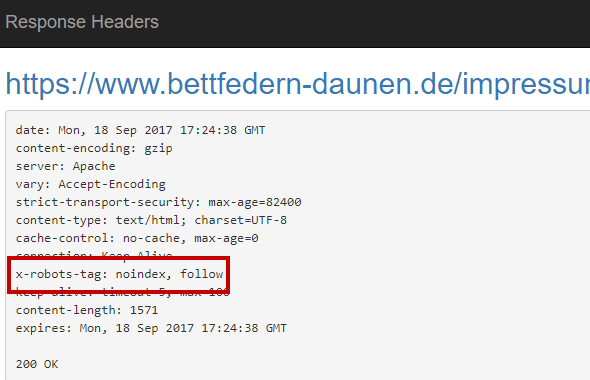
Header set X-Robots-Tag "noindex, follow" env=NOINDEX
Die erste Zeile setzt eine Markierung, sobald die aufgerufene Adresse zum Muster passt. Die zweite hängt daraufhin das noindex an die Antwort. Das follow sorgt dafür, dass die Links auf diesen Seiten weiterhin verfolgt werden, was bei Pflichtseiten mit voller Navigation wichtig ist.
Impressum, Datenschutzhinweise, AGB, Widerrufsbelehrung, Bildnachweise, Dankesseiten nach Formular oder Bestellung, dazu technische Dateien wie readme.txt, Lizenzdateien und die Sitemap selbst. Warum das so ist und wie du es bei HTML-Seiten löst, steht ausführlicher in meinem Beitrag Impressum und Datenschutz auf noindex setzen.
Ein Satz zur Vorsicht zum Schluss: Der X-Robots-Tag wirkt auf alles, was zum Muster passt. Ein zu weit gefasster Ausdruck sperrt schnell mehr aus als gedacht, im schlimmsten Fall halbe Verzeichnisse. Deshalb nach jeder Änderung stichprobenartig prüfen, ob wirklich nur die gemeinten Dateien betroffen sind.
Suchmaschinenoptimierung
Bing beliefert Copilot, ChatGPT, DuckDuckGo und Ecosia. So trägst du deine Seite in zehn Minuten in die Bing Webmaster Tools ein, bestätigst sie und hältst sie mit IndexNow aktuell.
Ein Anmeldeformular gibt es bei Google nicht. Was stattdessen hilft: Search Console, Sitemap, Indexierung beantragen, interne Links. Und woran es scheitert, wenn Seiten draußen bleiben.
Sollen Impressum, Datenschutz und AGB bei Google auftauchen? Die kurze Antwort lautet nein. Warum das so ist und wie du es sauber einstellst.
Wenn du das nicht selbst umsetzen willst, übernehme ich es. Ein Telefonat reicht, um zu klären, ob sich das für dich lohnt.